Kafka remplace vos middlewares — une supply chain de 200 magasins pilotée par 3 agents IA
TL;DR — Ce qu’un distributeur met 4 heures à traiter — détecter une rupture, décider un réappro, exécuter le transfert, tracer la décision — trois agents IA sur Kafka le font en 30 secondes. MCP Confluent pour interroger les topics en langage naturel, KIP-932 pour le scaling élastique, un skill métier pour la logique de décision. Zéro middleware, code exécutable.
Au sommaire
- 1. Pourquoi cet article, pourquoi maintenant
- 2. Le use case — réapprovisionnement retail
- 3. Pourquoi Kafka plutôt qu’un orchestrateur
- 4. MCP Confluent — l’agent qui voit Kafka comme une API
- 5. Skill métier — la logique de décision sans code
- 6. KIP-932 Share Groups — le scaling élastique natif
- 7. Le pipeline complet en 30 secondes
- 8. Ce qui tourne vraiment
- 9. Démonstration et prochaine étape
- Références
1. Pourquoi cet article, pourquoi maintenant
| L'évolution de Kafka et des agents IA a convergé en une décennie. Deux trajectoires distinctes — l'une côté infrastructure de streaming, l'autre côté frameworks d'agents — qui se rejoignent en 2026 au point de ne plus nécessiter la moindre couche de glue. |
Deux briques récentes changent la donne :
| Brique | Date | De quoi il s’agit | Référence |
|---|---|---|---|
| MCP Confluent | GA juillet 2026 | Un serveur MCP open-source qui expose 50+ primitives Kafka — topics, consumer groups, schémas Avro, Flink SQL, connectors — comme des tools appelables en langage naturel par n’importe quel agent compatible (Claude, Cursor, ADK). L’agent n’apprend pas le protocole Kafka ; il appelle des tools, le MCP traduit. | Docs Confluent · GitHub |
| KIP-932 Share Groups | GA avril 2026 (broker/Java) | Introduit les share groups : une consommation coopérative où N consommateurs lisent les mêmes partitions sans la contrainte 1 consommateur = 1 partition. Chaque message suit un cycle fetch → lock → ack/release, avec retry natif (delivery_count). Kafka devient une file de tâches, sans RabbitMQ. Note : le client Python confluent-kafka est encore en Preview — seule l’API Java est GA. |
KIP-932 (Apache) |
Ce que cet article démontre : ces deux briques en action sur un cas concret.
- Domaine : réapprovisionnement d’une chaîne de distribution — 200 magasins, 50 produits
- Résultat : 4 heures de circuit humain → 30 secondes de pipeline automatique
- Pourquoi ce cas : c’est le terrain sur lequel j’évolue actuellement — plateforme data d’un grand acteur du retail français. Le réapprovisionnement est un cas d’école représentatif des défis qu’on y rencontre : des flux temps réel par milliers (les stocks qui descendent), des décisions qui doivent être traçables (l’audit réglementaire), et des pics de charge imprévisibles (200 anomalies à 8h du matin, 3 à 14h). Ce sont les mêmes contraintes qu’on retrouve dans la fraude, la modération ou la maintenance — tout pipeline où des agents spécialisés doivent coopérer sur des événements sans middleware de glue. Si le pattern tient ici, il est transférable.
2. Le use case — réapprovisionnement retail
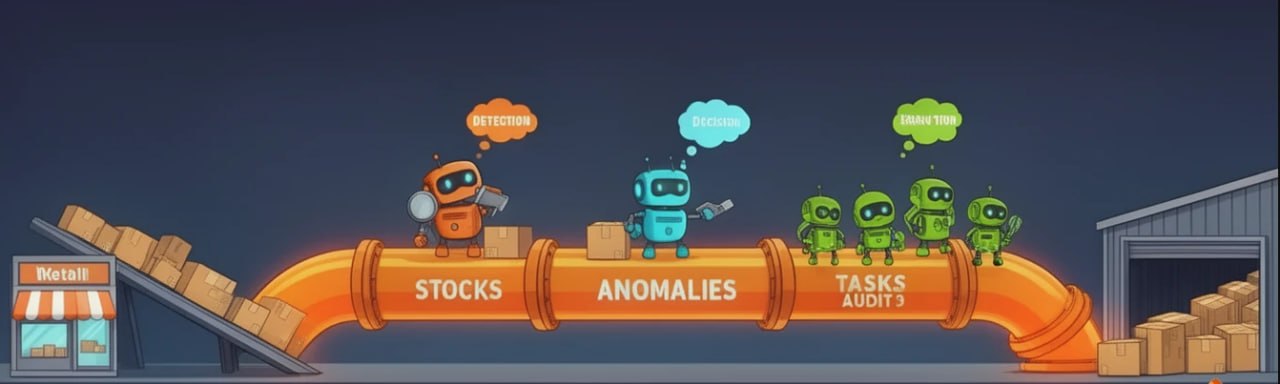
Un distributeur exploite 200 magasins, chacun référençant 50 produits. Chaque produit a un seuil minimum de stock par magasin. Dès qu’un stock passe sous ce seuil, une anomalie est détectée, une décision de réapprovisionnement est prise — transfert depuis un magasin voisin ou commande fournisseur — la tâche est exécutée, et l’opération est journalisée.
flowchart TD
    A["Réseau de 200 magasins × 50 produits<br/>chaque produit a un seuil minimum par magasin"] --> B{"Stock d'un produit<br/>< seuil minimum ?"}
    B -- Non --> A
    B -- Oui --> C["Anomalie détectée<br/>(rupture de stock imminente)"]
    C --> D{"Un magasin voisin<br/>a-t-il du stock disponible ?"}
    D -- Oui --> E["Décision : transfert interne<br/>depuis le magasin voisin"]
    D -- Non --> F["Décision : commande fournisseur"]
    E --> G["Exécution de la tâche<br/>(transfert ou commande)"]
    F --> G
    G --> H["Traçabilité : journal d'audit"]
Le circuit humain actuel — remontée d’information, analyse, validation, exécution — prend environ 4 heures par anomalie. Avec 200 magasins et 50 produits, le volume d’anomalies quotidien peut atteindre plusieurs centaines. L’automatisation n’est pas un luxe, c’est une nécessité opérationnelle.
Le use case est volontairement simplifié — 200 magasins, 50 produits, une seule règle de décision. L’objectif n’est pas de modéliser un réseau de distribution réel avec ses entrepôts, ses contraintes logistiques et ses fournisseurs multiples, mais d’isoler le pattern architectural : comment des agents coopèrent sur Kafka sans middleware de glue. La complexité métier s’ajoute en enrichissant le
SKILL.md— l’architecture, elle, ne change pas.
Le code source complet, les règles métier détaillées et les instructions pour exécuter le PoC sont sur github.com/arabaaoui/kafka-for-agents.
3. Pourquoi Kafka plutôt qu’un orchestrateur
On aurait pu coder ça avec un workflow engine, une file de tâches, un orchestrateur Python. Le problème, c’est que chaque brique aurait nécessité un middleware différent :
| Brique | Approche classique | Problème |
|---|---|---|
| Interroger les flux de données | API REST custom sur Kafka | Une couche de glue à maintenir |
| Distribuer les tâches | RabbitMQ ou SQS | Deux stacks à opérer |
| Éviter les doubles exécutions | Lock distribué (Redis) | Un composant de plus à surveiller |
| Tracer les décisions | Base de données d’audit | Synchro Kafka → DB à coder |
L’architecture retenue fait le pari inverse : tout sur Kafka. Pas de glue. Pas de middlewares. Trois agents, cinq topics, et les primitives natives de la plateforme.
graph TB
    SIM["Simulateur<br/>200 magasins × 50 produits"] -->|stocks| KAFKA

    subgraph KAFKA["Apache Kafka 4.2.1 (KRaft)"]
        STOCKS[("stocks")]
        ANOMALIES[("anomalies")]
        TASKS[("tasks")]
        AUDIT[("audit")]
    end

    STOCKS -->|poll 5s| DET["Agent Détection<br/>MCP Confluent"]
    DET -->|produce_anomaly| ANOMALIES
    ANOMALIES -->|poll 3s| DEC["Agent Décision<br/>SKILL.md métier"]
    DEC -->|produce_task| TASKS
    DEC -->|log_audit| AUDIT
    TASKS -->|ShareGroup KIP-932| EXE["Agent Exécution ×N<br/>scale horizontal"]
4. MCP Confluent — l’agent qui voit Kafka comme une API
L’Agent Détection n’a pas de KafkaConsumer codé en dur. Il utilise le serveur MCP
Confluent — un bridge qui expose les primitives Kafka (consume-messages, list-topics,
get-topic-config) comme des tools que l’agent ADK peut appeler en langage naturel.
sequenceDiagram
    participant K as Kafka (stocks)
    participant P as Agent Détection (ADK)
    participant M as MCP Confluent
    participant A as Kafka (anomalies)

    K->>P: stock P-42 = 5, seuil_min = 20
    P->>P: pré-filtre déterministe : 5 < 20 → candidat
    P->>M: call_mcp("consume-messages", {topic:"stocks", max_messages:5})
    M-->>P: historique récent du produit P-42
    P->>P: qualification LLM : sévérité, tendance
    P->>A: produce_anomaly("rupture_stock", CRITIQUE)
L’agent ne « sait » pas interroger Kafka. Il sait appeler des tools. Le bridge MCP traduit. Si demain on change de cluster Kafka, l’agent ne change pas — seul le endpoint MCP change.
5. Skill métier — la logique de décision sans code
L’Agent Décision ne contient pas de if stock_voisin > besoin: transfert() else: commande().
Sa logique est dans un fichier SKILL.md, lu une fois au démarrage et injecté dans
l’instruction de l’agent :
SKILL: supply-chain-replenishment
1. Identifier le produit et le magasin concernés
2. Vérifier le stock des magasins voisins (même région)
3. Si transfert possible → générer ordre de transfert
4. Sinon → générer commande fournisseur prioritaire
5. Si produit périssable → ajuster la quantité (buffer +10%)
6. Logger la décision dans le topic audit
sequenceDiagram
participant A as Kafka (anomalies)
participant P as Agent Décision (ADK)
participant S as Kafka (stocks voisins)
participant T as Kafka (tasks)
participant AU as Kafka (audit)
Note over P: instruction = prompt + SKILL.md<br/>(chargé au démarrage)
A->>P: anomalie: P-42, Lyon-Part-Dieu, qty=5
P->>S: get_neighbor_stocks("Lyon", "P-42")
S-->>P: Bellecour: 200u, Confluence: 80u
P->>P: applique SKILL.md → transfert possible
P->>T: produce_task(transfert, 50u, Bellecour→Part-Dieu)
P->>AU: log_audit(décision, raison=voisin avec surplus)Le métier peut modifier la règle sans toucher une ligne de Python. Le skill est dans Git — versionné, reviewable, auditable. Un
docker compose restart decision-agentet la nouvelle règle est en production.
6. KIP-932 Share Groups — le scaling élastique natif
Le matin à 8h, 200 anomalies sont détectées (pic de la nuit). L’Agent Exécution doit traiter 200 tâches en quelques minutes.
Sans share groups, le scaling est plafonné par le nombre de partitions : 3 partitions = 3 agents max. Avec KIP-932, tous les agents coopèrent sur les mêmes partitions :
stateDiagram-v2
    [*] --> AVAILABLE: tâche produite dans tasks
    AVAILABLE --> ACQUIRED: fetch par Agent-7 (lock 30s)
    ACQUIRED --> ACKNOWLEDGED: ACK après exécution réussie
    ACQUIRED --> AVAILABLE: crash agent → lock expire → retry
    ACQUIRED --> DEAD: delivery_count > 5 → abandon

    note right of ACQUIRED
        Les N-1 autres agents continuent
        de fetcher sur les mêmes partitions.
        Pas de rebalance. Pas de limite.
    end note
# Pic de charge à 8h
docker compose up -d --scale execution-agent=20
# → 200 tâches traitées en 2 minutes
# Creux à 14h
docker compose up -d --scale execution-agent=2
# → redescente sans rebalance, sans perte de messageKafka devient une file de tâches native. Plus besoin de RabbitMQ à côté. Le
delivery_countnatif gère les retries. Si un agent crashe en plein traitement, le lock expire après 30 secondes et la tâche est automatiquement remise en circulation.
7. Le pipeline complet en 30 secondes
sequenceDiagram
    participant S as Simulateur
    participant D as Détection (ADK + MCP)
    participant DEC as Décision (ADK + SKILL.md)
    participant E as Exécution ×N (KIP-932)
    participant A as Audit

    S->>D: stock P-42 Lyon-Part-Dieu = 5 (seuil=20)
    D->>D: pré-filtre → MCP → qualification CRITIQUE
    D->>DEC: anomalie: rupture_stock, P-42, Part-Dieu

    DEC->>DEC: vérifie voisins → Bellecour a 200u
    DEC->>DEC: SKILL.md → transfert interne 50u
    DEC->>E: task: transfert(Bellecour→Part-Dieu, 50u)
    DEC->>A: audit: décision=transfert, raison=surplus voisin

    E->>E: exécute transfert (ACK après succès)
E->>A: audit: task completed, 2.0s| Étape | Durée | Ce qui se passe |
|---|---|---|
| t=0s | — | Le simulateur publie un stock sous le seuil |
| t=5s | +5s | L’Agent Détection qualifie l’anomalie via MCP |
| t=8s | +3s | L’Agent Décision choisit le transfert en appliquant SKILL.md |
| t=10s | +2s | L’Agent Exécution traite la tâche et acquitte |
| t=10s | — | La décision est journalisée dans l’audit |
30 secondes pour ce qui prenait 4 heures en circuit humain. Sans un seul if codé en
dur dans la logique métier. Sans middleware de glue entre les briques.
8. Ce qui tourne vraiment
Le PoC est exécutable — pas une maquette, pas des print() qui font semblant.
Chaque agent est un vrai google.adk.Agent avec un vrai LLM derrière :
| Agent | Stack | Mode déterministe |
|---|---|---|
| Détection | ADK + LiteLLM (OpenAI/Anthropic/Gemini) + MCP Confluent | Anomalie basique sans qualification LLM |
| Décision | ADK + SKILL.md injecté + tools Kafka réels | Commande fournisseur par défaut |
| Exécution | ShareConsumer natif (ACK/RELEASE/REJECT) + scaling natif | Délai fixe 2s, 100% succès |
Et si vous n’avez pas de clé LLM sous la main, chaque agent bascule en mode déterministe. Le pipeline tourne de bout en bout sans rien payer.
Note sur le ShareConsumer natif — le client Python
confluent-kafkaexposeShareConsumeren Preview depuis la version 2.15.0. Le PoC l’utilise directement pour le cycle de vie KIP-932 —AVAILABLE → ACQUIRED → ACKNOWLEDGED, expiration des locks, compteur de tentatives, dead-letter. Reste une limite du client Preview : pas d’actionRENEW, ce qui empêche de prolonger un verrou pendant un appel LLM long — un agent lent sur un traitement risque de perdre son lock avant d’avoir acquitté. Détail complet dans le README du repo.
git clone https://github.com/arabaaoui/kafka-for-agents.git
cd kafka-for-agents
cp .env.example .env   # laisser vide = full déterministe
make all               # cluster Kafka test + agents + simulateur
make check             # vérifier que tout tourne
Kafka UI sur http://localhost:8081 permet de voir les messages circuler en temps réel
à travers les 5 topics. make check affiche l’état des consumer groups, le nombre de
messages par topic, et les dernières anomalies/tâches.
9. Démonstration et prochaine étape
Ce que cet article a démontré :
- MCP Confluent permet à un agent IA d’interroger Kafka sans connaître le protocole
Kafka — il appelle des tools, le MCP traduit. L’Agent Détection consomme les stocks,
qualifie les anomalies, et publie dans le topic
anomalies. - Un skill métier dans un simple fichier
SKILL.mdsuffit à guider les décisions d’un agent sans coder la logique en dur. L’Agent Décision vérifie les stocks voisins, choisit entre transfert et commande fournisseur, et trace chaque décision. - KIP-932 Share Groups transforme Kafka en file de tâches native avec scaling
élastique. L’Agent Exécution passe de 2 à 20 instances en une commande, sans rebalance,
sans limite de partitions, sans RabbitMQ. Le PoC utilise directement le
client Python
ShareConsumer(Preview depuis la version 2.15.0), à l’exception de l’actionRENEW, absente de ce client tant qu’il n’est pas passé en GA. - Le pipeline complet — 200 magasins, 50 produits, trois agents — tourne en 30 secondes de bout en bout, là où le circuit humain prenait 4 heures.
Cette architecture fait disparaître deux middlewares : la glue d’accès aux données (MCP remplace les scripts AKHQ/API REST) et la file de tâches externe (KIP-932 remplace RabbitMQ/SQS). Mais elle repose sur un skill métier chargé localement — un fichier markdown monté dans un container.
Le prochain article change de terrain : les agents ne sont plus dans le flux métier, ils sont autour — l’ops. Un poison message bloque un consumer group facturation. L’agent diagnostique la cause exacte via MCP en 2 minutes — là où un ops mettrait 30 à 90 minutes à la main. Le fix, lui, reste manuel : une commande CLI de 30 secondes. Pas d’écriture sur le cluster, pas d’autonomie déléguée — l’agent élimine le temps de diagnostic, pas le jugement humain. Un use case concret, toujours.
Références
- MCP Confluent — serveur MCP open-source exposant Kafka aux agents IA : documentation Confluent · code source
- KIP-932: Queues for Kafka — share groups et consommation coopérative : KIP sur le wiki Apache Kafka
- PoC kafka-for-agents — code source complet du pipeline supply chain : github.com/arabaaoui/kafka-for-agents
Les agents utilisent Google ADK, LiteLLM pour le multi-provider, et Kafka 4.2.1 en KRaft. Testable localement avec Docker en deux commandes.
Commentaires